Chapter 6 : ডেটাবেজ ম্যানেজমেন্ট সিস্টেম ICT

HSC ICT এর Chapter 6 : ডেটাবেজ ম্যানেজমেন্ট সিস্টেম অধ্যায়ের বোর্ড প্রশ্ন ও MCQ অনুশীলন করো।

২০৪

প্রশ্ন

ICT

বিষয়

HSC

ক্লাস

সাম্প্রতিক প্রশ্ন

HSCICTসৃজনশীল

উদ্দীপক
question image

Sylhet · 2017

ক
SQL কী?

উত্তর

SQL এর পুরো অর্থ হচ্ছে Structured Query Language। এটি একটি অনন্য শক্তিশালী ডেটা মেনিপুলেশন ও ডেফিনেশন ল্যাঙ্গুয়েজ।
খ
ইনডেক্স করা ফাইলে ডেটা এন্ট্রি করা হলে স্বয়ংক্রিয়ভাবে আপডেট হয়- বুঝিয়ে লেখ।

উত্তর

ইনডেক্স করার পরে ডেটাবেজ ফাইলে নতুন কোনো রেকর্ড ইনপুট করা হলেও ইনডেক্স ফাইলগুলো স্বয়ংক্রিয়ভাবে আপডেট হয়ে যায়। কারণ এক বা একাধিক ফিল্ডের উপর ভিত্তি করে ইনডেক্স করা যায়। কোনো ডেটা টেবিলে এক বা একাধিক ইনডেক্স থাকতে পারে কিংবা একাধিক ইনডেক্স একই সময় খোলা থাকতে পারে কিন্তু একই সময় কেবল একটি ইনডেক্স সক্রিয় থেকে রেকর্ড সমূহ প্রদর্শনের অর্ডার নিয়ন্ত্রণ করে। ফলে সক্রিয় ইনডেক্স এর কারণে ডেটা স্বয়ংক্রিয়ভাবে আপডেট হয়।
গ
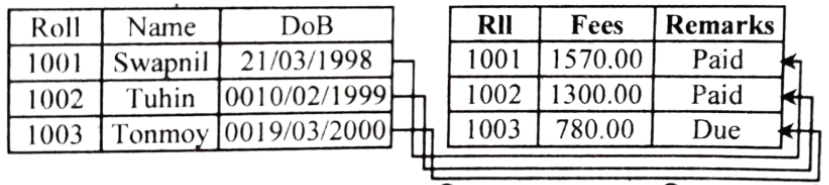
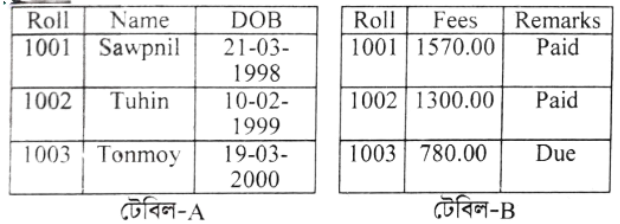
উদ্দীপকে উল্লিখিত টেবিল-A এর ফিল্ডগুলোর ডেটা টাইপ বর্ণনা করো।

উত্তর

উদ্দীপকে টেবিল A-এর ফিল্ডের ডেটা টাইপ নিচে দেওয়া হলো- টেবিল-A এর ১ম ফিল্ড- প্রথম ফিল্ড হচ্ছে নিউমেরিক ডেটা টাইপ। যে সকল ডেটা দ্বারা কোনো সংখ্যা বোঝানো হয় তাকে নিউমেরিক ডেটা বলে। অর্থাৎ নিউমেরিক ডেটা হচ্ছে সংখ্যা বিষয়ক ডেটা। বিভিন্ন ধরনের সংখ্যা বিষয়ক ডেটা নিচে আলোচনা করা হলো- ইন্টিজার বা পূর্ণ সংখ্যা ডেটা- এ ধরনের ডেটায় কোনো ভগ্নাংশ থাকে না। পূর্ণ সাংখ্যিক ডেটা ধনাত্মক বা ঋণাত্মক হতে পারে। যেমন- ১২৫, -৪৫০ ইত্যাদি। ফ্লোটিং পয়েন্ট বা ভগ্নাংশ ডেটা- ফ্লোটিং পয়েন্ট সংখ্যা বলতে বোঝায় মূলদ সংখ্যা যার ভগ্নাংশ থাকতে পারে। যেমন: ৩.৫, ৪.৫০ ইত্যাদি। উদ্দীপকে রেজাল্ট এর জন্য এই ফ্লোটিং পয়েন্ট ডেটা ব্যবহার করা হয়। টেবিল-A এর ২য় ফিল্ড- দ্বিতীয় ফিল্ড হচ্ছে নন-নিউমেরিক ডেটার অন্তর্গত স্ট্রিং ডেটা (String Data)। স্ট্রিং ডেটা সাধারণত অনেকগুলো ক্যারেক্টার মিলে স্ট্রিং গড়ে উঠে। উদাহরণ- কলম, Apple, Orange ইত্যাদি স্ট্রিং টাইপের ডেটা। টেবিল-এর ৩য় ফিল্ড- চতুর্থ ফিল্ড হচ্ছে নন-নিউমেরিক ডেটার অন্তর্গত Date/Time ডেটা। Date/Time ডেটা তারিখ ও সময় জাতীয় ডেটার ক্ষেত্রে এ ডেটা টাইপ ব্যবহার করা হয়। উদাহরণ- Date of Birth, Joining Date, Admission Date ইত্যাদি।
ঘ
উদ্দীপকে উল্লিখিত টেবিলদ্বয়ের মধ্যে কোন ধরনের রিলেশন তৈরি সম্ভব? যুক্তিসহকারে বিশ্লেষণ করো।

উত্তর

উদ্দীপকে প্রথম টেবিলে শিক্ষার্থীর রোল, নাম ও জন্মতারিখ বিদ্যমান আছে। আবার দ্বিতীয় টেবিলে শিক্ষার্থীর রোল, ফিস এবং রিমার্কস সংরক্ষিত আছে। ফলে দুইটি টেবিলের মধ্যে শিক্ষার্থী রোল একটি কমন ফিল্ড। এই কমন ফিল্ড এর মাধ্যমে দুটি টেবিলের মধ্যে one-→−one\to-one রিলেশন সম্ভব। টেবিল-A এর Roll হচ্ছে প্রাইমারি কি। টেবিল-B তেও Roll আছে। নিম্নে টেবিল-১ ও টেবিল-২ এর মধ্যে one-→−one\to-one রিলেশন দেখানো হলো- question image উপরের টেবিল দুইটির মধ্যে Roll ফিল্ড এর মাধ্যমে রিলেশন তৈরি করা হয়েছে। কারণ দুইটি টেবিলের রিলেশন তৈরির শর্ত হচ্ছে টেবিল দুইটির মধ্যে একটি কমন ফিল্ড বিদ্যমান থাকবে। উপরের টেবিল দুইটির মধ্যে Roll নামে একটি কমন ফিল্ড বিদ্যমান থাকায় রিলেশন তৈরি করা সম্ভব হয়েছে।

সম্পূর্ণ প্রশ্ন দেখো

HSCICTসৃজনশীল

উদ্দীপক

question image

Barisal · 2017

ক
SQL কী?

উত্তর

SQL এর পুরো অর্থ হচ্ছে Structured Query Language। এটি একটি অনন্য শক্তিশালী ডেটা মেনিপুলেশন ও ডেফিনেশন ল্যাঙ্গুয়েজ।
খ
ডেটাবেজ ইনডেক্স ফাইল স্বয়ংক্রিয়ভাবে আপডেট হয়- ব্যাখ্যা করো।

উত্তর

ইনডেক্স হচ্ছে সুসজ্জিতভাবে বা সুবিন্যাস্ত ভাবে তথ্যাবলির সূচী প্রণয়ন করা। ডেটাবেজে টেবিল ইনডেক্স করা থাকলে তা থেকে সহজেই কোন রেকর্ড খুঁজে বের করা যায়। ডেটাবেজের এক বা একাধিক ফিল্ডের উপর ভিত্তি করে ইনডেক্স করে Alphabetically বা Numerically সাজানো যায়। ফলে ইনডেক্স করার পরে ডেটাবেজ ফাইলে নতুন কোন রেকর্ড ইনপুট করা হলেও ইনডেক্স ফাইলগুলো স্বয়ংক্রীয়ভাবে আপডেট হয়ে যায়। যদি একাধিক ফিল্ডের উপর ইনডেক্সিং করা থাকে তবে টেবিলে ডেটা আপডেট করলে ইনডেক্স আপডেট হতে বেশি সময় লাগে।
গ
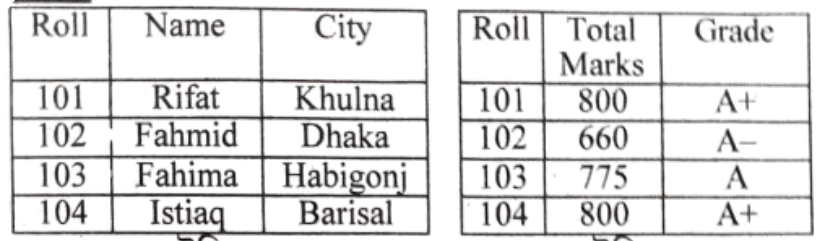
উদ্দীপকের আলোকে ডেটা টাইপ ব্যাখ্যা করো।

উত্তর

উদ্দীপকের আলোকে ডেটা টাইপ নিচে ব্যাখ্যা করা হলো- ১. নিউমেরিক ডেটা- যে সকল ডেটা দ্বারা কোন সংখ্যা বোঝানো হয় তাকে নিউমেরিক ডেটা বলে। অর্থাৎ নিউমেরিক ডেটা হচ্ছে সংখ্যা বিষয়ক ডেটা। যেমন- Student Table এর Roll No, Total Marks হচ্ছে নিউমেরিক ডেটা। ২. ক্যারেক্টার ডেটা- ক্যারেক্টার টাইপের ডেটা বলতে যেকোনো বর্ণ, প্রতীক বা চিহ্ন ফরম্যাটিং কোড, কন্ট্রোল কোড বা অন্যান্য বিশেষায়িত কোড বুঝায়। যেমন- Student Table এর Name, City, Grade ইত্যাদি হচ্ছে ক্যারেক্টার টাইপ ডেটা।
ঘ
উদ্দীপকে উল্লিখিত টেবিল দুটির মধ্যে সম্পর্ক তৈরির সম্ভাব্যতা ও সুবিধা যাচাই করো।

উত্তর

উদ্দীপকের টেবিল দুটির মধ্যে রিলেশন প্রয়োজন। কারণ- Student Table-1 এর অন্তর্গত শিক্ষার্থীর Roll No দ্বারা Student Table-2 এর অন্তর্গত শিক্ষার্থীর গ্রেডপয়েন্ট জানার জন্য রিলেশন প্রয়োজন। Student Table-1 এবং Student Table-2 এর মধ্যে কমন ফিল্ড থাকায় One to One রিলেশন সম্ভব। টেবিল দুইটির মধ্যে সম্পর্কের কারণে যেসকল সুবিধা পাওয়া যায় তা নিচে আলোচনা করা হলো- ১. সহজে টেবিল তৈরি করে ডেটা এন্ট্রি করা যায় ২. ডেটা টেবিলের সাথে অন্য এক বা একাধিক ডেটা টেবিলের মধ্যে রিলেশন তৈরি করা যায় ৩. অসংখ্য ডেটার মধ্য থেকে প্রয়োজনীয় ডেটাকে খুঁজে বের করা যায় ৪. ডেটা ভ্যালিডেশনের সাহায্যে ডেটা এন্ট্রি নিয়ন্ত্রণ করা যায় ৫. সহজে এক ডেটাবেজ থেকে অন্য ডেটাবেজের সাথে তথ্য আদান প্রদান করা যায় ৬. সংখ্যাবাচক ডেটাসমূহে সূক্ষ গাণিতিক কাজ করা যায় ৭. সহজে নানা ফরম্যাটের রিপোর্ট তৈরি করা যায় ও তা মুদ্রণ করা যায় ৮. প্রয়োজনীয় তথ্য নিয়ে লেবেল তৈরি করা যায় এবং ছাপানো যায়। ৯. বিভিন্ন ধরনের চার্ট তৈরি করা যায় ১০. আকর্ষণীয় ডেটা এন্ট্রি ফর্ম তৈরি করা যায় ১১. অন্যান্য ডেটাবেজ প্রোগ্রাম (যেমন-ফক্সপ্রো, এক্সেল ইত্যাদি) থেকে তথ্য বা ডেটা এনে ব্যবহার করা যায়।

সম্পূর্ণ প্রশ্ন দেখো

HSCICTসৃজনশীল

উদ্দীপক

question image

Chittagong · 2017

ক
রেকর্ড কী?

উত্তর

পরস্পর সম্পর্কযুক্ত একাধিক ফিল্ডের সমন্বয়ে গঠিত হয় একটি রেকর্ড।
গ
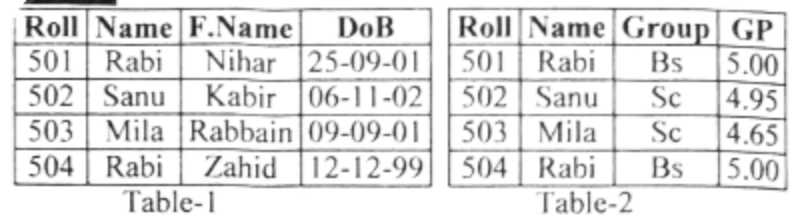
উদ্দীপকে Table-2 তে Roll ফিল্ডটি না থাকলে কী সমস্যা হতো- বিশ্লেষণ করো।

উত্তর

উদ্দীপকে প্রথম টেবিলে শিক্ষার্থীর রোল, নাম, পিতার নাম, জন্মতারিখ বিদ্যমান আছে। আবার দ্বিতীয় টেবিলে শিক্ষার্থীর রোল, নাম, গ্রুপ, জিপিএ ইত্যাদি সংরক্ষিত আছে। ফলে দুইটি টেবিলের মধ্যে শিক্ষার্থী রোল একটি কমন ফিল্ড। এই কমন ফিল্ড এর মাধ্যমে দুটি টেবিলের মধ্যে one-to-one রিলেশন সম্ভব। কিন্তু Table-2 তে ফিল্ডটি না থাকলে দুইটি টেবিলের মধ্যে রিলেশন তৈরি সম্ভব নয়। ফলে টেবিলদ্বয়ের মধ্যে কোনো প্রকার গাণিতিক, সিদ্ধান্তমূলক, গবেষণামূলক কাজ করা সম্ভব হবে না। নতুন কোনো তথ্য সংযোজন করলে তা স্বয়ংক্রিয়ভাবে অন্য টেবিলে হালনাগাদ হবে না। এছাড়া সকল শিক্ষার্থীর যেকোনো তথ্য অনুসন্ধান করা কঠিন হয়ে যাবে।
ঘ
উদ্দীপকের Table-1 ও Table-2 এর মধ্যে রিলেশন তৈরির শর্তগুলো বিশ্লেষণ করো।

উত্তর

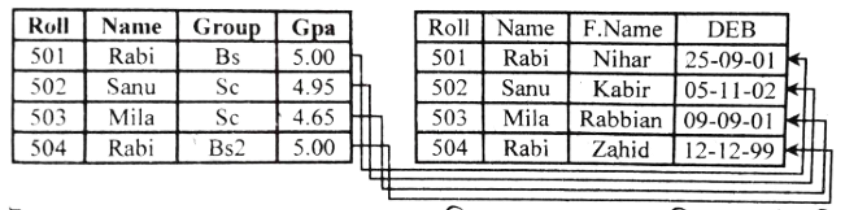
উদ্দীপকে প্রথম টেবিলে শিক্ষার্থীর রোল, নাম, পিতার নাম, জন্মতারিখ বিদ্যমান আছে। আবার দ্বিতীয় টেবিলে শিক্ষার্থীর রোল, নাম, গ্রুপ, জিপিএ ইত্যাদি সংরক্ষিত আছে। ফলে দুইটি টেবিলের মধ্যে শিক্ষার্থী রোল একটি কমন ফিল্ড। এই কমন ফিল্ড এর মাধ্যমে দুটি টেবিলের মধ্যে one-→−one\to-one রিলেশন সম্ভব। টেবিল-১ এর Roll হচ্ছে প্রাইমারি কি (key)। টেবিল-২ তেও Roll আছে। নিম্নে টেবিল-১ ও টেবিল-২ এর মধ্যে one-→−one\to-one রিলেশন দেখানো হলো- question image উপরের টেবিল দুইটির মধ্যে Roll ফিল্ড এর মাধ্যমে রিলেশন তৈরি করা হয়েছে। কারণ দুইটি টেবিলের রিলেশন তৈরির শর্ত হচ্ছে টেবিল দুইটির মধ্যে একটি কমন ফিল্ড বিদ্যমান থাকবে। উপরের টেবিল দুইটির মধ্যে Roll নামে একটি কমন ফিল্ড বিদ্যমান থাকায় রিলেশন তৈরি করা সম্ভব হয়েছে।

সম্পূর্ণ প্রশ্ন দেখো